
購読する ニュース - 業界
Googleは、テキスト、画像、音声、動画のあらゆる組み合わせを生成されたクリップに変換し、ユーザーが平易な言語による編集を通じて結果を微調整できる、新しい「Omni」ファミリーの最初のモデル「Gemini Omni Flash」を発表した。このモデルは本日、GeminiアプリおよびGoogle Flowを通じて、Google AI Plus、Pro、Ultraの加入者に提供が開始され、今週からYouTube ShortsおよびYouTube Createアプリでも無料で利用可能になる。
Google I/Oで、Google DeepMindのCTO兼チーフAIアーキテクトであるKoray Kavukcuoglu氏によって発表されたOmniは、Veoのテキストと画像主導のアプローチから、単一のプロンプト内で参照メディアを組み合わせることができるマルチモーダルなパイプラインへと、同社の動画生成スタックを拡張するものだ。Googleはこのモデルを「Geminiの推論能力と創造能力が出会う地点」と位置付けており、動画に続いて画像や音声の出力も計画されている。
この分野を追っている人にとって、Omni FlashはVeo 3.1と並んで位置づけられる。Veo 3.1は、Googleが今年初めにネイティブの縦型フォーマット、4Kアップスケーリング、キャラクターの一貫性向上を盛り込んでアップデートしたものであり、同社がNano Bananaのリリースを通じて推進してきたより広範なGemini画像系モデル群の一環でもある。その売り込みポイントは、以前のツールとは異なる。テキストから動画、画像から動画への変換を別々のワークフローとして扱うのではなく、Omniは混合入力をネイティブで受け入れるのだ。
マルチモーダル入力を中核とする提案
Omniは画像、テキスト、音声、動画を参照として取り込み、それらを単一の生成出力に統合する。ユーザーは静止画、動きや照明の参考となる短いクリップ、テンポやムードを示す音声ファイル、そして文章による説明を提供でき、モデルはこれらすべてを調和させて一貫性のある動画として生成するよう設計されている。リリース時点では、音声入力は音声リファレンスに限定されているが、Googleは他の音声入力形式も順次追加されるとしている。
複数のターンにわたる対話型編集
2つ目の柱は、反復的な言語駆動型編集だ。クリップが作成されると、ユーザーは自然な言語による指示を繰り返し与えてそれを洗練させることができる。環境、カメラアングル、スタイル、あるいは具体的な詳細を変更しても、モデルはターン間の連続性を維持するよう設計されている。
Googleの例には、「人物が鏡に触れたとき、鏡を液体のように美しく波立たせ、その人物の腕を反射する鏡の素材に変えて」といったプロンプトが含まれており、元のシーンのキャラクターや物理挙動がその後の編集にも引き継がれる。この位置づけにより、Omniはワンショット生成ツールというよりは、対話型コンポジターに近い存在として位置づけられている。
複数の編集にわたり一貫した流れを維持することは、この分野における長年の弱点の一つだったが、Googleはこの点で明確な進歩を主張している。モデルとの対話を通じて動画を編集し、反復処理を経てもキャラクターやシーンの論理が維持されるという約束は、数回のやり取りを超えて機能するのであれば、実に魅力的だ。
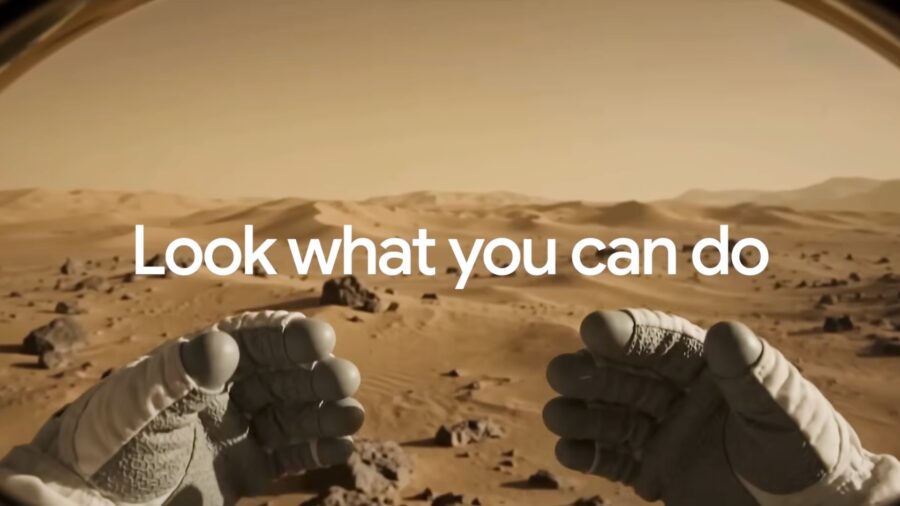
物理法則、世界知識、解説コンテンツ
Googleはまた、Omniを物理的な妥当性の面で一歩前進したものと位置付けており、重力、運動エネルギー、流体力学の処理が改善された点を挙げている。デモ用のプロンプトには、曲を演奏するバイオリニスト、連鎖反応のトラックを転がるビー玉、そしてタンパク質の折りたたみを説明するクレイアニメ風のストップモーション解説などが含まれる。
このモデルはGeminiの広範な知識ベースにも依存しており、Googleはこれにより、単なるパターンマッチングではなく、事実に基づいた解説動画を生成できると謳っている。ドキュメンタリーや教育用映像の制作者にとって、これはより興味深い機能だが、その能力はケースバイケースで精査が必要だ。事実関係に微妙な誤りがある、一見説得力のある映像は、明らかに合成されたものよりもむしろ不適切だと言える。
デジタルアバターと音声の問題
より挑発的な新機能は「Avatars」だ。これはユーザーが自身のデジタルアバターを作成し、自分の声で動画を生成できる機能だ。Googleは、より広範な音声・スピーチ編集機能(具体的には、既存の動画内の音声を編集する機能)を責任を持ってユーザーに提供する方法について、現在も検討中であり、これらの機能はまだ有効化されていない。
これは一部の競合他社とは顕著な対照をなしている。既存のクリップ内の台詞を変更する機能こそが、編集や政治の文脈においてAI動画ツールが真に危険なものとなる点であり、少なくとも現時点ではその機能の提供を見送るというGoogleの判断は、業界が直面せざるを得なくなった領域に対する認識を反映している。
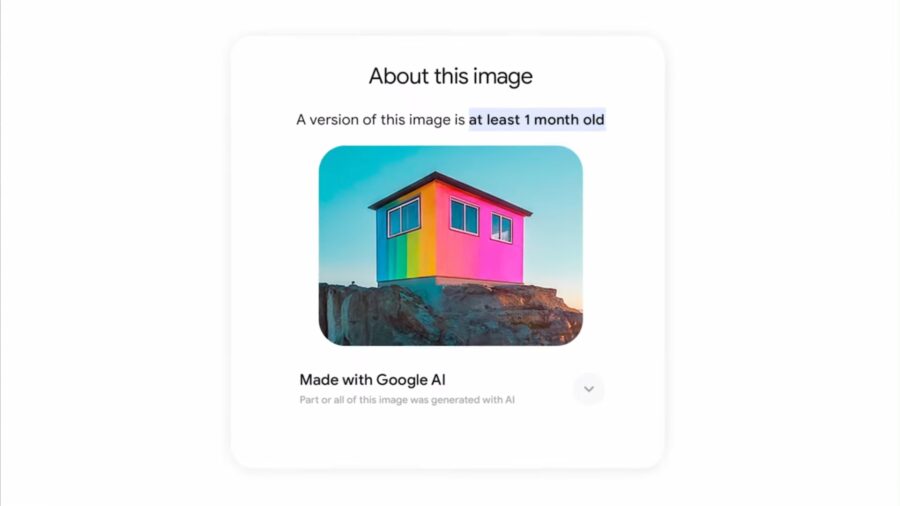
透かしと出所情報
Omniによって生成されたすべての動画には、SynthIDというデジタル透かしが埋め込まれている。GoogleはVeoやLyriaを含む、自社の生成型メディア出力全体にこの透かしを埋め込んでいる。この透かしは、Geminiアプリ、Chrome版Gemini、およびGoogle検索を通じて検証可能だ。
今年初めにByteDanceのSeedance 2.0に対しハリウッド全体から反発が起きたことを受け、来歴追跡ツールの重要性はかつてないほど高まっている。同モデルのリリースから数時間のうちに、トム・クルーズやブラッド・ピットをはじめとするトップスターが出演する捏造クリップが拡散したことがきっかけだ。SAG-AFTRA、全米映画協会、ディズニーは、このモデルとそれが可能にした手法を非難した。それ以来、すべてのモデルベンダーに対し、検証可能な透かし機能を実装するよう求める圧力は急激に高まっており、Googleは明らかにOmniを、この議論において正しい立場に置くよう位置づけている。
現役の映画制作者にとっての意義
プロにとっての課題は、Omniがクリエイティブなプロンプトから印象的なクリップを生成できるかどうかという点よりも、実際の制作パイプラインに組み込めるかどうかという点にある。Google Flowは、同社の動画モデルを中核に据えた広範なクリエイティブワークスペースであり、昨年ダレン・アロノフスキーがDeepMindと共同で手掛けた『Primordial Soup』のようなプロジェクトでも使用された。これは有料サブスクライバー向けの統合拠点だ。動画生成、画像生成、そしてマルチモーダル編集を、一つの有料サービス傘下に統合するという戦略が、今や完全に明らかになった。
YouTube ShortsやYouTube Createアプリを利用するショートフォームクリエイターにとって、無料アクセスは状況を一変させ、今後数週間でOmni生成コンテンツが大量に生み出されることはほぼ確実だ。物語性や商業作品においては、より重要な試金石となるのは、対話型編集モデルがプレビズ、ムードリファレンス、あるいはスタイリッシュなインサートといった分野で実用的な足場を築き始めているAI動画ツールにとって有用となるほど、一貫性を十分に長く維持できるかどうかだ。
また、競争環境におけるGoogleの位置付けにも注目すべきだ。そのペースは劇的に加速している。Kling 3.0は2月にネイティブ4Kとマルチショットシーケンスを導入し、Seedance 2.0も同月に市場に登場し、前述のハリウッドからの反応を引き起こしたフォトリアリスティックな結果を実現した。マルチモーダル入力の処理は、この競争において残された数少ない明確な差別化要因の一つであり、GoogleはOmniを通じてまさにその領域で優位性を確立しようとしているようだ。